
В предишните уроци разгледахме част от фундаменталните типове данни: bool, int, short, long, long long, float, double. Вие придобихте основни знания за програмирането. Запознахте се с някои от структурите на програмния език C++. Логическата конструкция if – else и циклите с условие: do и do – while. Езика, който изучавате не е от най лесните за разбиране. Но в прости стъпки ще продължим изграждането на знания. Не се отказвайте!
В този урок ще ви запозная с масивите. Масивите са най – простата структура от данни. Ще ви запозная и с типа char. Него нарочно го пропуснах в урока за целите числа. В този урок го въвеждаме, той е малко по особен от другите цели типове. Ще въведем понятието string (масив съдържащ текст). Този урок е особено важен, за да се досетите как работят нещата на ниско ниво. Това се пропуска от уроците за някои други езици. Просто защото на съвременна машина не се губи от бързината на програмата и почти няма значение. Но щом говори за C/C++ си струва да го споменем.
Типа Char
Char е най – малкия примитивен тип за цяло число. Той заема един байт от паметта. Може да бъде signed или unsigned.
- unsigned char: стойности от 0 до 255;
- signed char: стойности от -128 до 127
Типа char рядко се използва за място където да се пази резултата от изчисление. Да, число е и може да участва в изрази. Но обхвата на този тип е прекалено малък и се избягва поради честото преливане на типа. Основната роля на char е да пази символ от ASCII таблицата. Това е наследство от пра стари времена. От времето когато е нямало модерни езици. А само C и други динозаври 🙂 Но типа се е запазил. Примитивен и лесен за разбиране.
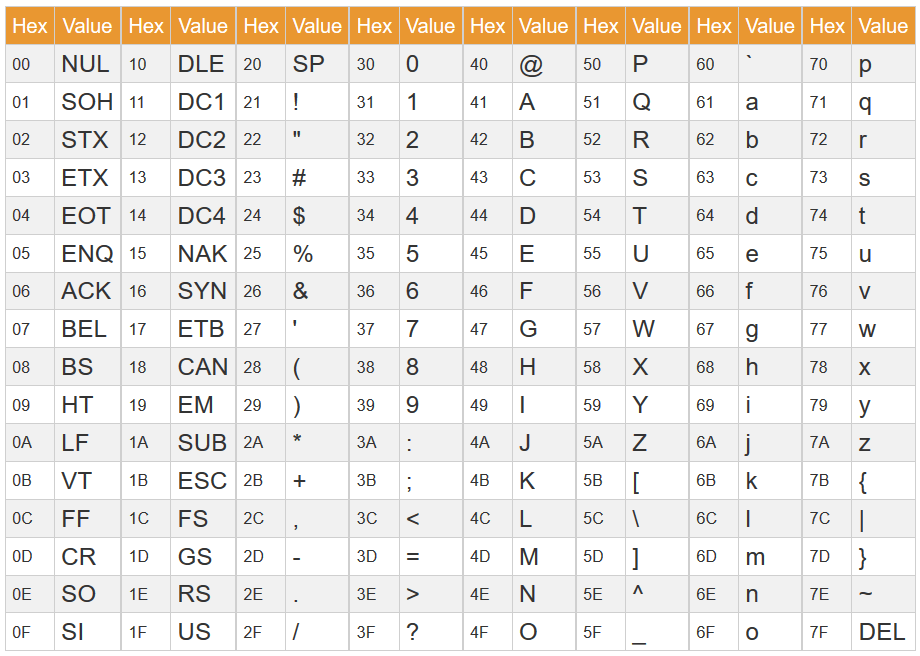
Горното показва първата половина от ASCII таблицата. Символите със стойност 0..127. Тя е неизменима (стандарт). Преди много години нямаше Unicode и всичко беше една голяма каша. Всяка страна имаше собствена кодова таблица разположена в долната половина. Числата от 128 до 255. И всичко беше един Ужас! Нямаше начин да си разменяме текст или документи. След 2000 година се въведе стандарта Unicode. И там всеки символ има своя код. Но този код се кодира с байтове. Така, че ето защо този древен тип данни не е заменен в C++. Може да кодира всичко. И char е най – малката логическа единица с която работи компютърната памет.
В долния пример показваме няколко начина на деклариране на променлива от тип char. Всички те означават едно и също. Буквата ‘C’.
#include <iostream>
using namespace std;

int main() {
    char c1 = 'C';           // буква
    char c2 = 67;            // десетично
    char c3 = 0103;          // осмично
    char c4 = 0x43;          // шесннайсетично
    char c5 = 0b01000011;    // бинарно

    cout << c1 << " " <<
            c2 << " " <<
            c3 << " " <<
            c4 << " " <<
            c5 << " " <<
    endl;
}Масив (array)
Масива е блок от последователна памет. Там се съхраняват променливи от един тип данни. Размера на масива е фиксиран и не се променя. Ето пример за декларация на масив:
int data[100];Декларацията е в същия синтаксис като фундаменталните променливи. Просто в скобите […] посочваме големината на масива. Или колко променливи искаме да има в него.
Но в горния пример масива не е инициализиран. Не сме му задали стойности.
int data[100] {};
int data[100] {0};Този код показва два начина на декларация и инициализиране на масив. И в двата реда просто задаваме 0 за всички променливи в масива. Можем да зададем стойност на всеки елемент от масива с цикъл.
Можем да зададем стойност на всяка клетка от масива. Тогава можем и да не задаваме дължината на масива. Да напишем [] и да оставим компилатора да свърши останалото:
int data[] = {1,2,3,4,5};В този случай компилатора разбира следното:
int data[5] = {1,2,3,4,5};Но какво би разбрал компилатора от следващия объркващ код?
int data[20] = {1,2,3,4,5};Спокойно. C++ е достатъчно умен. Kомпилатора ще инициализира първите пет клетки от масива с тези числа. После ще постави 0 в останалите. Но нека проверим:
#include <iostream>
using namespace std;

int main() {
    int data[20] = {1,2,3,4,5};
    int i = 0;
    while(i < 20) {
        cout << data[i] << " ";
        i++;
    }
}Резултата е:
1 2 3 4 5 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 Достъпа до елемент от масива се осъществява по неговия индекс. Индексите се броят от 0 до дължината на масива -1. Последния индекс на масив от 100 елемента е 99. C++ не прави проверка на индекса когато достъпвате елемент от масива. Ако излезете извън рамките на масива това е недефинирано поведение. Програмата крашва.
int values[100] {};
int a = values[0];   // вземаме стойността на първия елемент
values[99] = 12345; // задаваме стойност на последния елементВръзката между char и масивите
Char в масив съхранява текст. Това се нарича текстов масив или string. В края на масива компилатора автоматично добавя символа ‘\0’. Което е се ползва при извеждането на текст или операции със стрингове в стила на езика C. ‘\0’ означава „край на текста.
Функциите с които се работи с текстови низов в стила на езика C можете да разгледате тук.
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char hello[] = "Hello User";

    // пълна дължина
    cout << "sizeof " << sizeof(hello) << endl;

    // брой символи
    cout << "strlen " << strlen(hello) << endl;
}Това е само за пример. Езика C++, както и C никога не са разполагали със собствен примитивен тип данни за string.
В C++ има клас sed::string който работи динамично с текст.
Задачи
1. Напишете ваша функция StrLen(char[]). StrLen приема текстов масив. И връща боря символи преброени до ‘\0’.
Решение
#include <iostream>
using namespace std;

int StrLen(char str[]) {
    int count = 0;
    while(str[count] != '\0') {
        count++;
    }
    return count;
}

int main() {
    char gt[] = "Game of Thrones";
    int r = StrLen(gt);
    cout << r << endl;
}2. Пребройте колко гласни има в „I love my language“.
Решение
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char text[] = "I love my language.";
    int LEN = strlen(text);
    int i = 0;
    int count = 0;

    do {
        char c = text[i];
        i++;

        if (c == 'a' || c == 'e' || c == 'i' ||
            c == 'o' || c == 'u' || c == 'y' ||

            c == 'A' || c == 'E' || c == 'I' ||
            c == 'O' || c == 'U' || c == 'Y')
        {

            count++;
        }

    } while (i < LEN);

    cout << "Гласни: " << count << endl;
}3. Отпечатайте „hello world“ на обратно. Като преди това го запишете в друг текстов низ.
Решение
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char str[] = "hello world";
    size_t len = strlen(str);
    char result[len + 1];      // запазваме място за '\0'

    int i = 0;
    while(i < len) {
        size_t v = len - i - 1;
        result[v] = str[i];
        i++;
    }

    cout << result << endl;
}4. Заменете всички малки букви с големи.
Решение
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char str[] = "hello world";
    size_t len = strlen(str);

    int i = 0;
    while(i < len) {
        if(str[i] >= 'a' && str[i] <= 'z')
            str[i] = str[i] - ('a' - 'A');
        i++;
    }

    cout << str << endl;
}5. Даден ви е низ. Премахнете всички интервали от него. За по лесно използвайте друг низ.
Решение
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char str[] = "h e l l o w o r l d";
    size_t len = strlen(str);
    char rr[len + 1];

    int i = 0, v = 0;
    while(i < len) {
        if(str[i] != ' ') {
            rr[v] = str[i];
            v++;
        }
        i++;
    }
    rr[v] = '\0';

    cout << rr << endl;
}